À propos de Sécurité de l’IA Montréal
Nous relions les personnes qui, à Montréal, travaillent à rendre l’IA plus sûre.
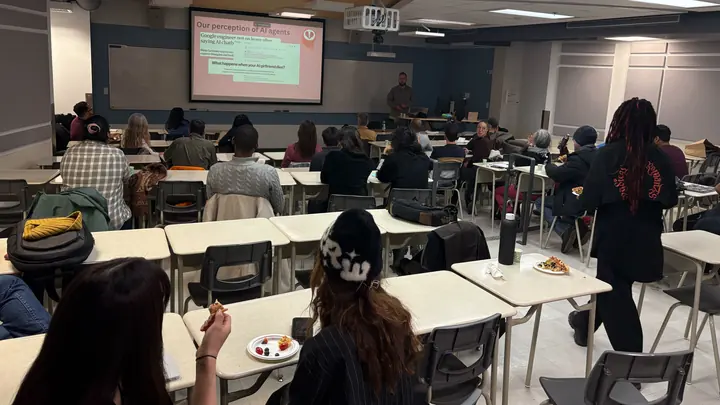
Ce que nous faisons
- Événements et conférences : rencontres, conférences et ateliers sur la sécurité, l’éthique et la gouvernance de l’IA (calendrier).
- Espace de cotravail et d’événements : un espace communautaire à Ω Labs pour travailler ensemble et organiser des rencontres.
- Programmes : ateliers, hackathons et accompagnement individuel (programmes).
- Infolettre : un résumé mensuel de la recherche, des événements et des politiques (lire et s’abonner).
- Écosystème : une carte des labos, instituts et groupes communautaires locaux (répertoire).
Qui l’organise
-
-
-
 Naïma Hassert
- Luth
- Olivier Coutu
S’impliquer
- Vous découvrez le domaine ? Commencez ici.
- Venez à un événement ou participez à un programme.
- Ajoutez votre événement ou organisation : team@horizonomega.org.
Ce que nous entendons par sécurité de l’IA
La sécurité de l’IA consiste à réduire le risque que des systèmes d’IA de plus en plus capables causent des dommages.
En tant que projet, nous jugeons qu’il y a plus d’une chance sur deux que des capacités transformatrices apparaissent d’ici dix ans, et que des défaillances graves, peut-être irréversibles, constituent d’ici là un risque réel. On confie à ces systèmes plus d’autonomie chaque année, y compris celui de développer l’IA elle-même.
Les défaillances, par cause :
- Désalignement et perte de contrôle : le système poursuit autre chose que ce que ses concepteurs voulaient, et peut résister aux corrections ou échapper à la supervision. On débat encore de sa forme, tromperie cohérente ou incohérence désordonnée, et la parade n’est pas la même.
- Usage malveillant : quelqu’un utilise délibérément un système capable pour causer du tort, des cyberattaques aux armes biologiques.
- Concentration du pouvoir : la concentration du contrôle sur une technologie décisive entre quelques mains, et les effets de discrimination, de surveillance et sur le travail que subissent déjà des personnes du fait des systèmes en usage aujourd’hui.
- Erreurs : les systèmes échouent de façon banale dans des déploiements à fort enjeu, et les conséquences croissent avec les pouvoirs qu’on leur confie. Les défaillances organisationnelles aggravent la situation : une supervision qui n’existe que sur papier, la dérive des pratiques, des quasi-accidents que personne ne signale.
Le travail contre ces défaillances prend des formes distinctes : interprétabilité et évaluations pour voir ce qu’un système fait, protocoles de contrôle et bacs à sable pour limiter ce qu’il peut faire, sécurité des poids des modèles et des outils, et règles encadrant qui peut développer et déployer ces systèmes.
Certains de ces constats reposent sur des mesures, d’autres sur des arguments. Des comportements stratégiques ont été observés en laboratoire : des modèles qui détectent qu’ils sont évalués et se comportent autrement, des modèles qui feignent de se plier à un entraînement contraire à leurs préférences, des modèles qui apprennent à dissimuler leurs écarts lorsque leur raisonnement est surveillé. Ce qui relève de l’argumentation plutôt que de la mesure, c’est de savoir si cela devient une tromperie durable dans un système en production, et où s’arrête la trajectoire des capacités. L’évaluation est en retard sur les capacités, de sorte que personne ne peut encore certifier à l’avance quelle défaillance produira un déploiement donné.
Références
- Bengio, Y., et al. (2026). International AI Safety Report 2026. arXiv:2602.21012.
- Bengio, Y., Hinton, G., et al. (2024). Managing extreme AI risks amid rapid progress. Science 384, 842–845.
- Shah, R., et al. (2025). An Approach to Technical AGI Safety and Security. Google DeepMind, arXiv:2504.01849.
- Hendrycks, D., Mazeika, M., Woodside, T. (2023). An Overview of Catastrophic AI Risks. arXiv:2306.12001.
- Greenblatt, R., et al. (2024). Alignment faking in large language models. arXiv:2412.14093.
- Baker, B., et al. (2025). Monitoring Reasoning Models for Misbehavior and the Risks of Promoting Obfuscation. arXiv:2503.11926.
- Schoen, B., et al. (2025). Stress Testing Deliberative Alignment for Anti-Scheming Training. arXiv:2509.15541.